[点晴永久免费OA]告别按量扣费的商业翻译接口:腾讯混元开源了 Hy-MT2 多语言翻译模型家族,把 33 国语言模型压成了 440MB 离线版
|
admin 2026年10月9日 10:0
本文热度 101
|
❝腾讯混元开源了 Hy-MT2 多语言翻译模型家族,能直接塞进手机或电脑本地离线跑。它专治商业翻译 API 收费贵、通用大模型翻译爱加废话的毛病,依靠“快思考”直出 33 种语言译文。
最酷的是 1.8B 版本极限压缩后仅 440MB,装进手机离线运行速度反倒快了 1.5 倍,效果还能硬刚主流商业翻译。
要点
一个家族三种规格:涵盖 1.8B 轻量版、7B 均衡版、30B-A3B(MoE 混合专家架构,总参数 30B、每次激活仅约 3B),全面覆盖从手机端侧到企业数据中心的部署需求。
33 种语言互译:除中、英、日、韩、法、俄、阿拉伯语等主流语言外,深度支持繁体中文、粤语、藏语、维吾尔语、蒙古语、哈萨克语等方言与少数民族语言。
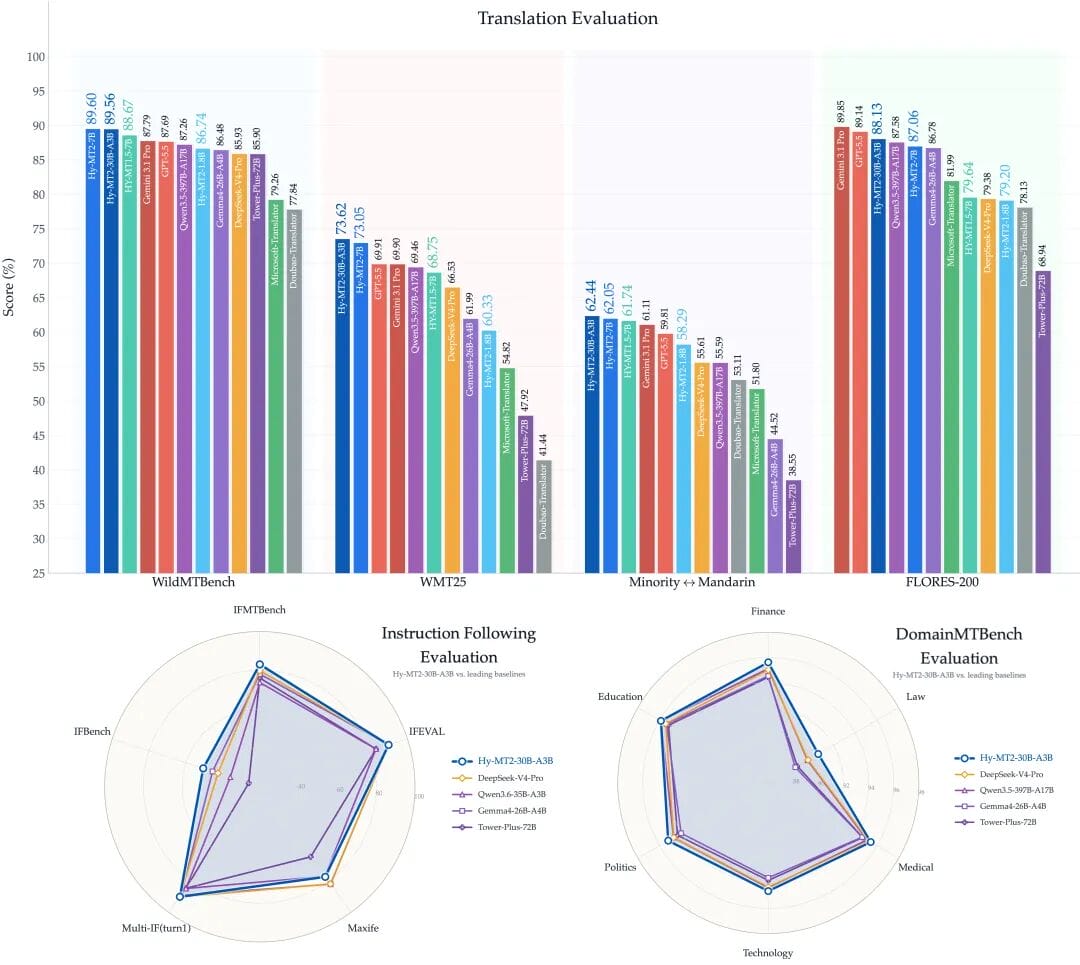
性能硬刚主流一线:官方评测显示,7B 与 30B-A3B 在快速思考模式下表现优于 DeepSeek-V4-Pro、Kimi K2.6 等开源大模型;端侧 1.8B 整体表现超越微软、豆包等主流商业翻译 API。
懂指令的专业翻译(杀手锏):内置 7 类专业翻译 Prompt 模板,涵盖默认翻译、术语约束、风格控制、个性化偏好、分隔符保持及结构化数据翻译(翻译 JSON/代码时能锁定键名、属性与变量占位符保持原样不译,专治通用大模型破坏代码结构的顽疾)。
端侧极限量化与极小体积:借助腾讯自研 AngelSlim 工具包的 1.25-bit 极限量化,1.8B 模型存储占用缩减至仅 440 MB,手机端推理速度反倒提升 1.5 倍;官方同步提供 FP8、GGUF(含 2-bit、1.25-bit)等丰富量化版本。
- 训练与评测全开源:提供完整训练管线,支持全参数微调与 LoRA,深度集成 DeepSpeed ZeRO 多种配置与 LLaMA-Factory;同步开源专门评测翻译指令遵循能力的 IFMTBench 评测集。
- 学术与赛事联动:与机器翻译顶级评测 WMT26 合作举办“视频字幕翻译任务”,选手使用 Hy-MT 系列模型参赛有机会赢取腾讯混元特设专项奖励。
上手
- 现成技能包免搭建:无需手动配环境,可直接通过 ClawHub 或 SkillHub 接入官方发布的“Hy-MT2-Translator Skill”技能包;
- 权重获取:全系列模型权重与 GGUF 量化版本已托管于 Hugging Face 与 ModelScope,个人电脑或端侧建议优先下载 1.8B 的 GGUF 版本。
- Transformers 推理:要求环境
transformers >= 5.6.0,加载时必须声明 trust_remote_code=True; - 高并发服务:官方支持 vLLM 与 SGLang 引擎部署(目前需拉取各自最新源码自行构建安装)。
- GGUF 版本强依赖团队提交给 llama.cpp 的自研 STQ kernel(PR #22836),需拉取包含该 PR 的 llama.cpp 源码后本地编译生成可执行文件;
- 官方示例命令中带
-ngl 0(即纯 CPU 推理),本地具备独显的用户可按需配置 GPU 层卸载加速。
- 1.8B / 7B:
temperature 0.7、top_p 0.6、top_k 20、repetition_penalty 1.05; - 30B-A3B:
temperature 0.7、top_p 1.0、top_k -1、repetition_penalty 1.0。 - 上下文限制:最大上下文为 8192(max_context: 8192),超长文章需提前切分段落输入;
- 系统提示词:模型没有默认 system prompt,直接输入 User 提示词即可;
- 算力选型:30B-A3B 适合多卡服务器使用张量并行(Tensor Parallelism)运行;个人单机端侧选 1.8B 量化版最为省心。
- 开源协议:Apache-2.0(模型与代码)/ CC-BY-4.0(IFMTBench 评测集)
- 开发团队:腾讯混元大模型团队(Tencent Hunyuan)
该文章在 2026/10/9 10:02:54 编辑过


 400 186 1886