大家好,SimdPaddleOCR 今天发布 2.0。这是项目第一次升大版本号,原因很简单:1.x 一直在折腾 CPU 上的 SIMD,2.0 加上了 GPU 后端,Windows / Linux / 安卓走 Vulkan,macOS 走 Metal。在我的 RTX 3080 Ti 上,medium 模型端到端比 1.4.2 快了 15 倍,CPU 路径的识别结果和 1.4.2 逐行相同。
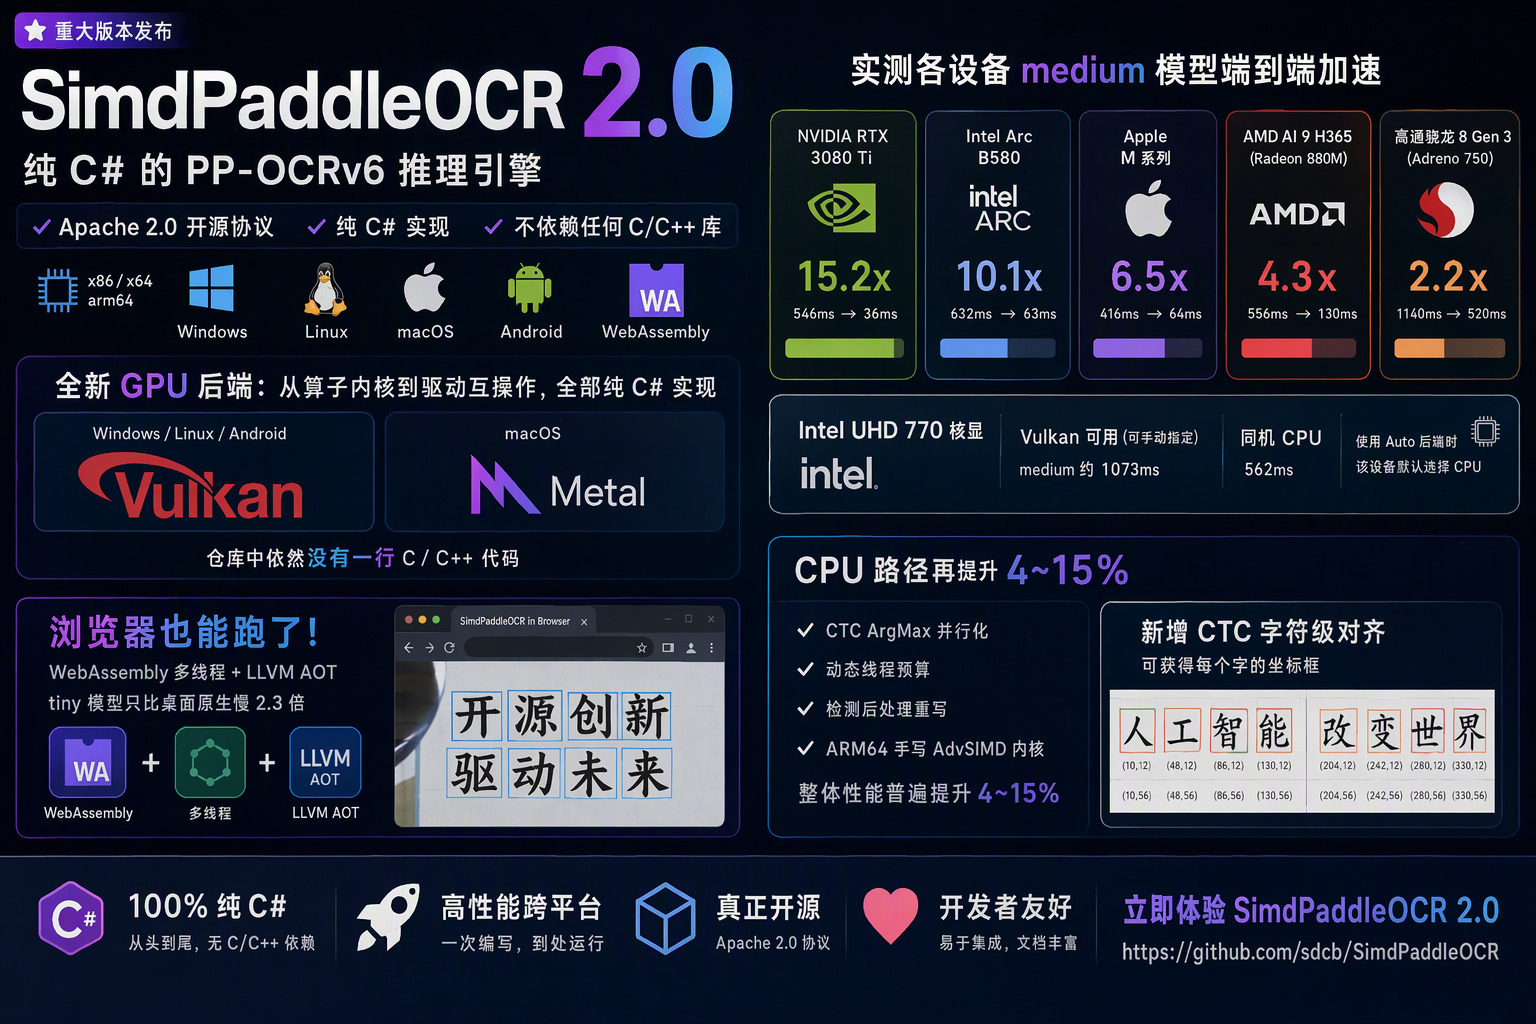
第一次看到这个项目的朋友,先简单介绍一下:这是一个纯 C# 实现的 PP-OCRv6 引擎,不依赖 Paddle Inference、ONNX Runtime,也不依赖 OpenCV。2.0 的 GPU 后端也守着同样的规矩,从算子内核调度到调用 Vulkan / Metal 的互操作代码都是 C#,仓库里没有一行 C/C++。
2.0 版本亮点速览
- 🚀 GPU 加速:在主流桌面显卡上,medium 模型获得最高 15 倍 的端到端性能提升。原生支持 Vulkan (Windows/Linux/Android) 和 Metal (macOS)。
- 💻 全平台制霸:除了传统的 Windows 和 Linux,现在还原生支持 安卓、macOS (Apple Silicon),甚至可以在浏览器 (WebAssembly) 中直接运行。
- ⚙️ CPU 持续优化:CPU 后端也没落下,在 ARM64 架构 (如 Neoverse N2) 上获得高达 1.25 倍 的性能提升。
- ✨ 新增功能:支持返回 CTC 时间戳,并提供了 逐字符 (Per-character) 包围盒 的估算能力,方便进行更精细的操作。
快速上手
升级 NuGet 包后不用改代码,Run 的签名和支持的像素格式(BGR / RGB / BGRA / RGBA)都没变,默认就是 Auto 模式,自动选择最优后端:
using var ocr = PaddleOcrAll.Load(ChineseV6SmallModels.Default);
PaddleOcrResult result = ocr.Run(bgr, width, height, stride);
如果想固定后端,或者让三个模型分别用不同后端(比如 DET 用 GPU、REC 留在 CPU),可以分别设置:
using var ocr = PaddleOcrAll.Load(ChineseV6SmallModels.Default, new PaddleOcrOptions
{
    Detector   = new PaddleOcrDetectorOptions   { Backend = OcrBackend.Vulkan },
    Recognizer = new PaddleOcrRecognizerOptions { Backend = OcrBackend.Vulkan },
    Classifier = new PaddleOcrClassifierOptions { Backend = OcrBackend.Vulkan },
});
想完全不用 GPU,就显式设置 OcrBackend.Cpu。
2.0 还有一个新参数 returnCtcAlignment。传 true 之后每一行会带上 CtcSpans(每个字符在 CTC 时间轴上的位置),调 line.EstimateCharacterBoxes() 能把它们映射回检测框,得到逐字符的四边形坐标:
PaddleOcrResult result = ocr.Run(bgr, width, height, returnCtcAlignment: true);
foreach (PaddleOcrLine line in result.Lines)
    foreach (PaddleOcrCharacterBox ch in line.EstimateCharacterBoxes())
        Console.WriteLine($"{ch.Text} @ ({ch.X1:F0},{ch.Y1:F0})");
字符框是估算的,对于敏感词涂黑、证件照打码这类 "按字符覆盖" 的场景已经足够。默认 false,不需要就不付这部分开销。
性能深度解析
主战场:桌面端 GPU 加速
这是 2.0 版本核心故事的发生地。在主流桌面显卡上,我们取得了巨大的性能飞跃。
RTX 3080 Ti:medium 从 546 ms 到 36 ms
测试机是我的开发机:Ryzen 7 5800X + RTX 3080 Ti(驱动 581.80),64 GB 内存,.NET 10.0.11。测试集是仓库自带的 100 张合成图,--workers 4、--warmup 1,取去掉首张后的中位数。
| 模型 | 1.4.2 CPU | 2.0 CPU | 2.0 Vulkan | Vulkan vs 1.4.2 | Vulkan vs 2.0 CPU |
|---|
| tiny | 55.1 | 49.6 | 22.1 | 2.5× | 2.2× |
| small | 191.1 | 166.8 | 27.4 | 7.0× | 6.1× |
| medium | 545.8 | 523.2 | 36.4 | 15.0× | 14.4× |
(单位:median ms/图)
medium 吞吐从每秒 1.8 张变成每秒 25 张。这个结果不是一开始就有的,中间主要踩了三个坑:
- 协作矩阵 GEMM 一开始很慢。 第一版内核最大的 GEMM 只有约 3.5 TFLOPS。重写之后改成共享内存双缓冲、向量化读写、按输出通道数选窄 tile 等优化,最大的几个 GEMM 到了 25–28 TFLOPS,端到端 medium 耗时从 125 ms 左右降到 40 ms 左右。
- 显存无界增长。 早期版本跑完 100 张图进程工作集最高涨到 24 GB。通过 graph 共享 arena、LRU 缓存、中间张量复用等方法修复后,现在 3080 Ti 上 medium 的进程工作集峰值是 984 MB,比纯 CPU 的 1170 MB 还低。
- REC 整张图都要放到 GPU 上。 为 SVTR 模型中特殊的算子(如 MaxPool batch, 5-D Transpose 等)逐个补齐了 GPU 实现,让 DET / CLS / REC 三个模型都整图在 GPU 上调度。
Intel Arc B580:同样获得 10.4 倍加速
在另一台 Ryzen 9 5950X + Intel Arc B580 的机器上,也取得了显著效果:
| 模型 | 1.4.2 CPU | 2.0 CPU | 2.0 Vulkan | Vulkan vs 1.4.2 | Vulkan vs 2.0 CPU |
|---|
| tiny | 72.2 | 66.0 | 22.2 | 3.3× | 3.0× |
| small | 237.3 | 205.9 | 32.3 | 7.3× | 6.4× |
| medium | 591.5 | 546.5 | 57.1 | 10.4× | 9.6× |
这证明了 GPU 后端在不同厂商的高性能显卡上都具有良好的普适性和性能。
无处不在:笔记本与集成显卡
除了发烧级显卡,在更常见的笔记本核显上,SimdPaddleOCR 同样表现出色。
AMD Radeon 880M 核显:也能快 4 倍
在一台锐龙 AI 笔记本的 Radeon 880M 核显上,我们针对其硬件特性(如 32KB 共享内存、无 Infinity Cache)增加了轻量 GEMM 变体,最终 medium 模型获得了 4.3 倍 的加速。
| 模型 | CPU | Vulkan | 加速 |
|---|
| medium | 516.1 | 118.1 | 4.3× |
Intel UHD 770:能跑,但跑不过 CPU
我们也在一台台式机的 Intel UHD 770 核显上进行了测试。这块核显没有协作矩阵扩展,在经过针对性优化后,GEMM 达到了其 fp32 峰值的 57–67%。但由于硬件算力所限,最终端到端耗时 1073 ms,慢于同机 CPU 的 562 ms。
这个例子展现了项目的严谨性:OcrBackend.Auto 会智能判断,在这类设备上自动回退到更快的 CPU 后端,确保用户总是获得最佳性能。
新大陆:移动端与 Web 端
最激动人心的部分是,SimdPaddleOCR 的纯 C# 血统使其成功登陆了移动端和 Web 平台。
骁龙 8 Gen 3:手机上也跑起来了!
在我的骁龙 8 Gen 3 手机上,通过 Vulkan 后端,我们成功在安卓原生应用中实现了 GPU 加速。在解决了 Adreno GPU 特有的一些编译和内存限制问题后,最终实现了 2.2 倍 (medium) 到 3.3 倍 (small) 的性能提升,且内存占用更低。
| 模型 | 手机 CPU | Vulkan | 加速 |
|---|
| small | 811.7 | 249.3 | 约 3.3× |
| medium | 3294.1 | 1466.4 | 约 2.2× |
WebAssembly:浏览器里的离线 OCR
项目代码不挑运行时,在浏览器 WebAssembly 中也能跑。开启 LLVM AOT 和多线程后,tiny 模型在 Edge headless 下仅比桌面原生慢 2.3 倍,吞吐达到 9.7 img/s,对于前端纯离线 OCR 场景已经完全够用。
| 模型 | 中位数 | 吞吐 | CER |
|---|
| tiny | 103.3 ms | 9.73 img/s | 2.30% |
为了覆盖苹果生态,我们编写了一套独立的 Metal 后端,和 Vulkan 共用同一套 GPU session 架构。所有互操作代码均通过 C# 的 P/Invoke 调用 Objective-C runtime 实现,没有 Swift 或 Objective-C++ 胶水代码。
在一台 M4 虚拟机上测试,medium 模型获得了 6.47 倍 的加速。
| 模型 | CPU | Metal | 加速 |
|---|
| tiny | 68.8 | 39.3 | 1.75× |
| small | 218.4 | 54.6 | 4.00× |
| medium | 693.0 | 107.0 | 6.47× |
在 GitHub Actions 的 M1 虚拟机上,也获得了约 2.8 倍的性能提升,证明了 Metal 后端的有效性。
其他技术细节
CPU 也快了一些
GPU 之外,CPU 路径在 2.0 里也有几处改进:
- REC 的 CTC ArgMax 改成并行,在多核 CPU 上,端到端性能提升 4%~15%。
- ARM64 手写 AdvSIMD 优化,在 Neoverse N2 上 tiny 模型获得 1.25 倍加速。
- DET 后处理重写了 flood-fill,将
det_postprocess 耗时从 5.4 ms 降到 2.2 ms。
精度
- CPU: 输出和 1.4.2 逐行相同,精度没有退化。
- GPU: 使用 fp16 会在阈值附近产生少量抖动,但总体 CER (字符错误率) 与 CPU 持平或略有改善。比如一张临界图片,GPU 会将两个竖排文本合并,原因是单个像素点概率跨过了阈值,属于 fp16 计算的正常现象。
已知限制
- GPU fp16 在低置信度下偶有结果翻转。彻底解决要上 fp32,暂时没做。
- 每次 dispatch 有约 55 µs 的固定开销,后续可通过算子融合继续优化。
- DET 和 REC 之间还没有做双流重叠。
- GPU 后端目前只在
net10.0 下可用。
总结与资源
支持的设备一览
OcrBackend.Auto 的自动选择逻辑保证了您在不同硬件上都能获得最优体验。
| 设备 | 后端 | 相对同机 CPU |
|---|
| RTX 3080 Ti | Vulkan(协作矩阵) | medium 14.4× |
| Intel Arc B580 | Vulkan(协作矩阵) | medium 9.6× |
| Apple M4(devin 虚拟机) | Metal | medium 6.47× |
| Apple M1(GH Actions 虚拟机) | Metal | tiny 约 2.8× |
| AMD Radeon 880M 核显 | Vulkan(协作矩阵) | medium 4.3× |
| 骁龙 8 Gen 3 / Adreno 750 | Vulkan(无协作矩阵) | medium 约 2.2× |
| Intel UHD 770 核显 | Vulkan(无协作矩阵) | medium 慢于 CPU,Auto 走 CPU |
测试数据集
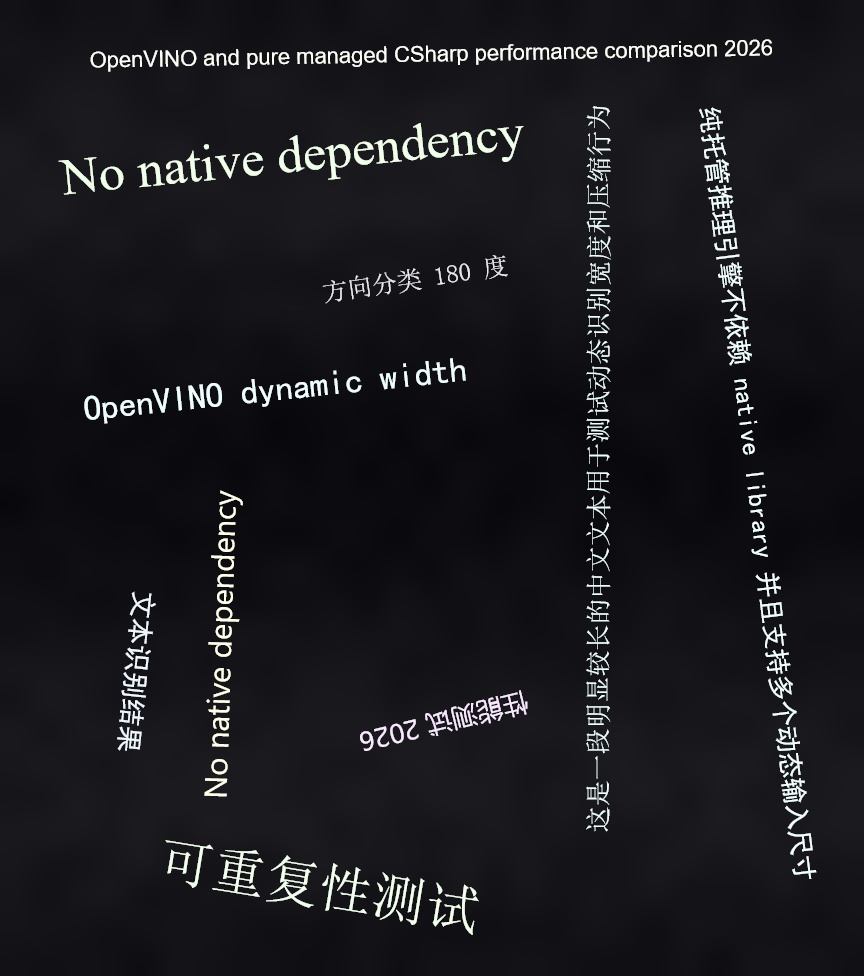
本文所有跑分的 JSON、复现命令都在仓库的 docs/ 目录下。测试数据集也已开源(Apache-2.0):
升级与交流
NuGet 把 Sdcb.SimdPaddleOCR 升级到 2.0.0 即可,模型包 1.0.0 不用动,项目依然是 Apache-2.0 协议。
GitHub 仓库:https://github.com/sdcb/SimdPaddleOCR,觉得有用的话欢迎点个 Star。


 400 186 1886